生成AIを使用した文章作成、特に小説執筆については、さまざまな意見が存在します。そもそもそれを創作と呼べるのかという議論がある一方で、制作ツールとして積極的に取り入れる動きもあります。
いずれにせよ、書き手にとっても読者にとっても、また、小説を掲載するプラットフォームにとっても、生成AIが無視できない存在になっているのはたしかです。
そうした状況を踏まえ、個人による書籍出版が可能な「Amazon Kindleダイレクト・パブリッシング(KDP)」や、小説投稿サイト「小説家になろう」「カクヨム」などでも、AI利用に関する申告ルールやガイドラインの整備が一気に進んでいます。
こうしたルールを前にして、次のように考える書き手もいるかもしれません。
「イラストや動画と違って、文章なら黙っていればAIだとはバレないのでは?」
「文章に電子透かしが入っていたとしても、自分の手で書き直してしまえば消えるのではないか」
結論からいえば、この疑問に対する答えは、半分イエスで、半分ノーです。
今回は、AI各社が公表している一次情報やデータを元に、テキストの電子透かしの現状と限界について解説します。
AI各社のテキスト電子透かしの現状
2026年8月2日、EU AI法(欧州人工知能法)に基づく透明性義務の適用が開始されました。この法律により、AI開発企業は、AIが生成したコンテンツを機械が判別できる形でマーキングすることが求められるようになっています。
- Anthropic(Claude):2026年8月2日以降に公開されたClaudeモデルでは、生成テキストへの不可視の電子透かしが標準実装されています。GoogleのSynthID-Textを応用したものです。EU域内とそれ以外でシステムを分けるのではなく、日本を含む全世界・全プラットフォーム(Web、アプリ、APIなど)で一律に適用されており、ユーザー側でオフにすることはできません。それより前に公開されたモデルについても、今後数カ月かけて透かしを追加していくとしています。
- Google(Gemini):Google DeepMindが開発したSynthID-Textという電子透かし技術が、2024年からGeminiのテキスト出力に組み込まれています。
- OpenAI(ChatGPT):2026年10月5日、独自のテキスト透かし技術であるtextGrainを発表しました。ChatGPTへの導入は、法規制の対象となるEU域内の利用者に限られています(API利用者には選択制で提供)。OpenAIは今回の導入にあたって、全世界の標準にはしないと明言しています。つまり、日本でChatGPTを使った場合、現時点では出力に透かしは基本的に入りません。
テキスト電子透かしの仕組み
画像ファイルであれば、ファイルの裏側にあるメタデータ領域に作成履歴を記録できます。しかし、メモ帳で扱うテキストは単なる文字の並びであり、裏側にデータを隠す場所がありません。また、目に見えない特殊文字を混ぜるような単純な方法では、すぐに除去されてしまいます。
そこで各社が採用しているのが、AIが次の言葉を選ぶ時の確率の偏りを暗号として文章自体に織り込む、統計的ウォーターマークと呼ばれる手法です。
言葉の選択確率をほんの少し操作する
AI各社の具体的な方式はそれぞれ異なりますが、代表的な考え方を単純化すると、次のようになります。
大規模言語モデル(LLM)が文章を生成する時、内部では文脈上、次に来る確率が高い単語や形態素(トークン)の候補をリストアップし、その中から言葉を選んでつなげています。
例えば、次のような小説のワンシーンがあったとします。
>冷たい雨がアスファルトを叩いていた。〇〇〇、彼は傘も差さずに歩き続けた。
この〇〇〇に入る接続詞として、AIの内部では、しかし、けれども、それでも、だが、といった複数の自然に見える候補が浮かびます。
電子透かしが入る場合、AIは直前の言葉の組み合わせを元に、AI企業だけが持つ秘密の暗号鍵を使って計算を行い、候補の言葉を、透かしに合致するグループ(仮に白グループとします)と、それ以外のグループ(黒グループ)に瞬時に振り分けます。そして、文章の自然さが損なわれない範囲で、白グループに入った言葉が選ばれる確率をほんの少しだけ高くして出力します。
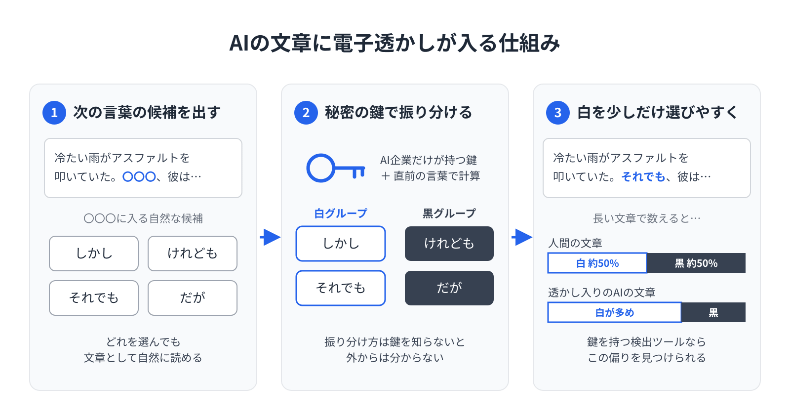
代表的な考え方を単純化したモデル
ちなみに、Anthropic(Claude)が公式に説明しているのは、以下のような仕組みです。
- 方式は、Google DeepMindが2024年にNatureで発表したSynthID-Textを応用したもの。
- 言葉を選ぶ時に、普通の乱数ではなく、鍵と、直前の数語を使って、次にどの語を選ぶかを決める。
- 文章に文字を足したり、隠し文字を入れたりはしない。
いずれにせよ、鍵を知っている者だけが、文章全体の言葉の選び方から透かしを読み取れる、という基本的な考え方は同じです。
文章が長くなるほど統計的な偏りが出る
たった1箇所で特定の言葉が選ばれただけでは、人間がたまたま選んだ言葉とまったく区別がつきませんし、読んでも違和感はゼロです。しかし、何百文字、何千文字と文章が続くうちに、言葉の選び方はもちろん、接続詞、助詞、語尾、句読点の打ち方に至るまで、あらゆる選択の場面で白グループに入った候補がわずかに多く選ばれ続けます。
あとからこのテキストを、暗号鍵の入った専用の検出ツールにかけたとします。この単純化したモデルでいえば、人間が書いた文章なら白グループと黒グループの言葉は、およそ50%ずつの割合で出現します。一方、AIが生成した文章では、白グループの言葉が統計的に有意に高い割合で検出されるため、このAIが出力した文章である可能性が高いと判定できる仕組みになっています。
文字の並び順そのものが透かしになっているため、Wordやメモ帳にコピー&ペーストしても、そのままの文章である限り透かしは消えません。
AI各社が認める技術の限界
ここまで読むと、AIが出力した文章はどんなことをしても絶対に見破られるのかと思うかもしれませんが、現実はそうではありません。AI開発企業自身が、現在のテキスト電子透かしは発展途上の技術であり、明確な限界があると公式に認めています。
書き手が知っておくべき技術的な限界は、大きく分けて3つあります。
1. 人間が手直しすると透かしは弱まる
テキスト電子透かしは、単語のつながり(連鎖)を元に、暗号の偏りを計算しています。そのため、AI生成文章をコピペしただけの無修正のものには高い精度を発揮しますが、人間が文章を書き換えるとシグナルは弱まっていきます。
OpenAIが2026年10月に公表したtextGrainの実験結果では、無修正の文章の検出率は200トークン(日本語の文章ならおよそ200〜300字程度の分量)で約80%、400トークンで約95%でした。
書き換えの影響を調べた別の実験では、400トークンの文章で、無修正なら約92%だった検出率が、単語の10%を同義語に置き換えると66%に低下し、25%を置き換えると17%にまで激減するという結果が出ています。
ただし、これらは条件を絞った実験での数値で、英語の文章の結果とみられます。OpenAIによれば、検出率は文章の長さだけでなく、分野や言語によっても大きく変わります。数学や料理のレシピのように、言葉の選択の余地が少ない文章では検出率が低下するようです。また、別の条件で行われた言語ごとの実験でも、言語によって40%台から60%台まで検出率に差が出ています。日本語の数値は公表されていないため、ここであげた数値がそのまま日本語の小説に当てはまるとは限りません。
一ついえることは、大幅な書き直しや言い換え(パラフレーズ)、人間が書いた文章との混在が起こると、透かしのシグナルが弱まるということです。
例えば、文章を書き慣れている人であれば、独自の表記ルールを持っており、AIの初稿を自分の文体やリズムに合わせて徹底的に書き直すことも多いと思います。そのように全編にわたって細かな改稿を行えば、結果として電子透かしの大部分が消えてしまうことは起こり得ます。
ちなみにAnthropicは、軽い編集では透かしはおそらく完全には消えないと説明しているので、編集の量というものが鍵になりそうです。
2. 使用法を区別できない
二つ目の限界は、AIの関与度を判別できないことです。
検出ツールがわかるのは、そのテキストがAIモデルによって出力・処理された形跡があるかどうかの可能性だけであり、人間がどれだけ創作に寄与したかは測定できません。
例えば、人間が100%自分で考えた原稿をAIに入力し、「読みやすく文章を整えて」と指示して出力させた場合でも、AIが書き換えた部分には電子透かしが埋め込まれます。機械の目からは、AIへの丸投げ作品なのか、人間が書いた作品をAIが手直ししたものなのかを見分けることができません。
ただし、透かしはAIが選んだ言葉にしか付かないため、誤字脱字や句読点を直すだけの軽い校正であれば、透かしが付く余地がほとんどありません。逆に、翻訳はAIがすべての言葉を選ぶため、透かしが入ってしまいます。
3. 誤判定のリスクがある
三つ目の限界は、人間が書いた文章を誤ってAIだと判定してしまう偽陽性(冤罪)のリスクを完全にはゼロにできない点です。
OpenAIのテストでも、約1%の偽陽性率が前提とされており、誤検出による不当な不利益が生じる可能性があります。
OpenAIは、こうしたリスクを理由の一つにあげて、検出ツールの提供を、承認を受けた研究者や専門機関に限っています。Anthropicも、EU法の要件に沿って、規制当局、報道機関、研究者、教育機関、法的な確認義務を負う企業などに限定して提供しています。
2026年10月現在、どちらも一般の人が自由に使える状態にはありません。
AI無申告が危険である4つの理由
「少し多めに手直ししておけば透かしは消えるし、検出ツールもまだ一般公開されていないから、黙ってAI不使用にしておいてもバレないんじゃないか」
ここまでの流れを見て、そう思った方もいるかもしれません。しかし、技術がまだ完璧ではない現状においても、無申告で押し通すことには4つのリスクが存在します。
1. 長編小説では手直ししない部分が残る
前述の、単語の25%を置き換えれば400トークン程度の短文では検出率が17%まで落ちるというデータ、これはあくまで数百文字の短いテキストにおける話です。
小説は、数万字から十万字以上に及ぶ巨大なテキストです。最初は丁寧に自分の言葉でリライトしていても、何万字も作業を続けるうちに、疲れや妥協から、この風景描写の段落はAIの文章がよくできているからそのまま使おう、といった箇所が出てきます。
作品全体としては3割を書き直したつもりでも、ほとんど手を入れていない数千字のブロックが作中に点在していれば、その部分から透かしのシグナルが検出される可能性が高まります。また、透かしを無理やり消そうとして言い換えツールに丸ごと通せば、今度は小説の命である文体が崩れ、作品としての魅力が損なわれてしまいます。
結局のところ、長編小説から電子透かしの痕跡を完全に消し去るには、文章全体に自分の手を徹底的に入れるしかありません。
2. 過去の作品が遡及されるリスク
無申告の最大の懸念材料となるのが遡及リスクです。
Anthropicは、検出APIの提供範囲を今後広げていく方針を明らかにしています。Googleも2026年10月7日に、画像・動画・音声の透かしを調べられる検出ツールを一般公開しました(テキストは一般公開版の対象外)。検出ツールは、少しずつ一般に開かれる方向に進んでいます。今後、大手出版社やプラットフォームが、コンプライアンス確認のために公式の検出APIを導入する可能性はあります。
重要なのは、Geminiでは以前から、Claudeでは2026年8月2日以降に公開されたモデルから、生成テキストに透かしがすでに埋め込まれているという事実です。今投稿した時点ではチェックされなかったとしても、Web上に公開されたテキストデータはそのまま残り続けます。近い将来、プラットフォーム側がAI企業の検出システムを導入したり、より高精度な解析技術が実用化されたりといったことは十分に考えられます。これはつまり、過去に遡ってAI生成の痕跡が検出されるリスクをずっと抱え続けるということでもあります。
今は透かしの入らないAIを使っていたとしても、安心はできません。OpenAIがテキスト電子透かしを全世界の標準にしないとしているのは、あくまで発表時点での話です。また、透かしとは別に、AI特有の言い回しを手がかりに、AIの文章かどうかを推定する外部の判定サービスも存在します。
3. プラットフォーム側の対策
AI開発企業による文章解析とは別に、小説投稿サイトや電子書籍ストアなどのプラットフォーム運営側も、AI対策を独自に強めています。
プラットフォーム側が見ているのは、文章の言い回しだけではないと考えられます。管理サーバーには、投稿速度、更新頻度、公開間隔といったユーザーの行動ログが記録されています。
人間が自力で執筆する場合、1日に執筆できる文字数にはどうしても物理的な限界があります。しかし、AIを利用して量産を行うと、毎日数万字を短時間で連続投稿したり、不自然なハイペースで作品を公開し続けたりといった行動パターンが必ずログに残ります。
実際「カクヨム」は、短期間での過剰な投稿に注意を呼びかけ、作品の公開停止やアカウントの利用停止もありうると明記しています。「小説家になろう」も、短期間の大量投稿によるランキングや新着欄の占拠を禁止行為として明文化しました。「Amazon KDP」でも、AIによる粗製乱造への懸念から、1日に出版できるタイトル数に上限を設けています。
文章の表面をどれだけ人間らしく手直ししたところで、人間には不可能なペースでの投稿は隠せません。もっともこれに関しては、無申告というよりAIでの量産に伴うリスクですが、規約違反や迷惑行為アカウントとして運営から目を付けられれば、申告の有無に関する調査やアカウント制限、最悪の場合はアカウントBANの対象になる可能性があります。
4. 商業化後に発覚した時の代償の大きさ
無申告のリスクが致命的になるのは、作品が高く評価され、コンテストでの受賞や書籍化といった商業契約の場に進んだ時です。
現在、Web小説コンテストや新人賞、商業出版においては、選考や契約の段階でAIの使用有無や具体的な使用方法を確認する流れが定着しつつあります。出版契約書にも、作品が自らの創作であり、規約違反や権利侵害がないことを約束する条項が盛り込まれることがほとんどだと思います。
もし、本当はAIを使ったのに、AI不使用として投稿した作品がヒットし、今さらAIを使ったとは言えずに嘘をついて商業契約を結んでしまったらどうなるのか。あとから虚偽申告が発覚すれば、受賞の取り消しや契約解除、既刊の回収といった損害だけでなく、嘘をついた作家として、最も大事な信用を失うことになりかねません。
まとめ:正直な申告こそが最善の自衛策になる
テキストの電子透かしは、現時点では完璧な技術ではなく、人間が手を加えれば薄まるし、それ単独ですべてを見抜けるほどの万能性もまだありません。
しかし、ここで考えるべきは、そもそもなぜリスクを冒してまでAIの使用を隠す必要があるのか、ということです。
「Amazon KDP」も「カクヨム」も「小説家になろう」も、AIを使って小説を書くこと自体は禁止していません。
「Amazon KDP」では、AIで本文を生成してもAI-generatedと申告すれば販売できますし、アイデア出しや推敲・編集にAIを使っただけ(AI-assisted)なら申告すら不要と明記されています。「小説家になろう」や「カクヨム」でも、AIの文章をそのまま使ったのか、素材にして自分で大幅に改稿したのか、アイデア出しなどの補助に使ったのかという区分に沿って設定・タグ付けを行えば、堂々と作品を公開できます(ただし「小説家になろう」は、全文をAIが生成した作品の投稿は禁止しています)。
各サービスが開示を求めているのは、AIを使った書き手を排除するためではなく、読者との無用なトラブルを防ぎ、商業化の際に作家と出版社の双方を契約リスクから守るためです。
AI使用を見抜かれる可能性を考え、透かしを消すための不毛な書き換え作業に時間を奪われ、将来検知技術が進化したらどうしようと怯え続けるのは、創作活動においてあまりにも大きなコストです。
技術の現在地を正しく知った上で、使ったものは使ったとルール通りに申告する、そうして後ろめたさを捨て、作品そのもののおもしろさや構成を磨くことに全力を注ぐことこそが、AI時代において書き手自身のキャリアと作品を守る、最も合理的で誠実なリスク管理といえるのではないかと思います。
出典
- How Claude’s text watermark works(Anthropic)
- OpenAI will watermark ChatGPT texts in EU, but there’s a catch(Cybernews)
- SynthID Detector Goes Public: Google’s Tool to Spot AI-Generated Content(IT-Connect)